Logo cxm1024 的博客

博客

CF920E Connected Components? 题解

avatar cxm1024 2025-12-01 12:52:19

本文章由 WyOJ Shojo 从洛谷专栏拉取,原发布时间为 2023-05-08 18:16:40

一道线段树优化建图好题(大雾

扣掉一些边看起来不好做,我们直接大力加上存在的边,然后跑连通块。对于一个点,如果他被扣掉了 $k$ 个邻居,那么没扣掉的那些形成了至多 $k+1$ 个连续段,可以用线段树优化建图向每个连续段各用 $\log$ 的代价连边。

由于总共扣掉了 $m$ 条边,所以总共连边的次数是 $O(m)$ 的,建图复杂度为 $m\log m$,产生 $O(n+m)$ 个点、$O(n+m)$ 条边的有向图。

注意到线段树优化建图建的是有向图,如果直接建无向图就会让所有点都在一个连通块。所以按照有向的线段树优化建图做法,如下:

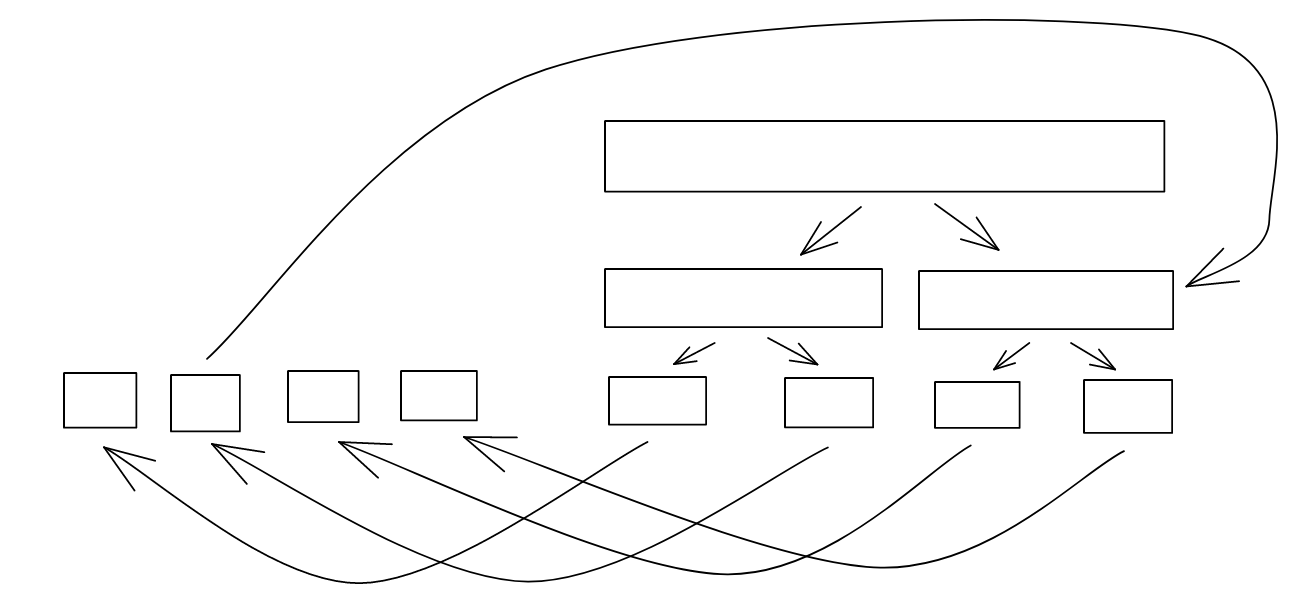
(图为 2 向 3,4 连边)(由于是点向区间连边,只需要一棵线段树即可)

注意到,在 $2$ 向 $3,4$ 连边时,$3,4$ 也会向 $2$ 连边,故连通块一定形成强连通分量,也不会产生直接连无向图的问题。于是最后对新图跑一下强连通分量即可。

#include <bits\/stdc++.h>
using namespace std;
vector<int> a[200010], e[600010];
int n, m, tot, rt;
struct node{int lson, rson;} t[600010];
#define mid (l + r) \/ 2
void build(int &now, int l = 1, int r = n) {
	if (l == r) {now = l + n; return;}
	now = ++tot;
	build(t[now].lson, l, mid), build(t[now].rson, mid + 1, r);
	e[now].push_back(t[now].lson), e[now].push_back(t[now].rson);
}
void add(int now, int ql, int qr, int x, int l = 1, int r = n) {
	if (ql <= l && qr >= r) {e[x].push_back(now); return;}
	if (ql <= mid) add(t[now].lson, ql, qr, x, l, mid);
	if (qr > mid) add(t[now].rson, ql, qr, x, mid + 1, r);
}
int dfn[600010], low[600010], cnt;
int st[600010], top, col[600010], colcnt, sz[600010];
bool in[600010];
void dfs(int now) {
	low[now] = dfn[now] = ++cnt;
	st[++top] = now, in[now] = 1;
	for (int v : e[now]) {
		if (!dfn[v]) dfs(v), low[now] = min(low[now], low[v]);
		else if (in[v]) low[now] = min(low[now], dfn[v]);
	}
	if (low[now] == dfn[now]) {
		colcnt++;
		while (st[top] != now)
			col[st[top]] = colcnt, in[st[top]] = 0, top--;
		col[st[top]] = colcnt, in[st[top]] = 0, top--;
	}
}
signed main() {
	scanf("%d%d", &n, &m), tot = n * 2;
	for (int i = 1; i <= m; i++) {
		int x, y;
		scanf("%d%d", &x, &y);
		a[x].push_back(y), a[y].push_back(x);
	}
	for (int i = 1; i <= n; i++)
		e[i + n].push_back(i);
	build(rt, 1, n);
	for (int i = 1; i <= n; i++) {
		a[i].push_back(0), a[i].push_back(n + 1);
		sort(a[i].begin(), a[i].end());
		for (int j = 1; j < a[i].size(); j++) {
			if (a[i][j - 1] + 1 == a[i][j]) continue;
			add(rt, a[i][j - 1] + 1, a[i][j] - 1, i);
		}
	}
	for (int i = 1; i <= tot; i++)
		if (!dfn[i]) dfs(i);
	for (int i = 1; i <= n; i++)
		sz[col[i]]++;
	sort(sz + 1, sz + colcnt + 1);
	vector<int> ans;
	for (int i = 1; i <= colcnt; i++)
		if (sz[i]) ans.push_back(sz[i]);
	printf("%d\n", (int)ans.size());
	for (int x : ans) printf("%d ", x);
	puts("");
	return 0;
}

ABC176F Brave CHAIN题解

avatar cxm1024 2025-12-01 12:52:19

本文章由 WyOJ Shojo 从洛谷专栏拉取,原发布时间为 2023-01-19 22:47:55

更好的观看体验

题意:有 $3n$ 张卡片,每张有一个 $1\sim n$ 的数字。每次可以将最左边的 $5$ 张卡片任意排列,删掉前 $3$ 张,如果这三张数字相等则得一分;最后剩下的三张如果相等也的一分。求最大总得分。

模拟一下这个过程可以发现,相当于你有两张“手牌”,每次新加入三张,你从五张中扔掉三张,还是剩下两张。于是可以考虑一个 DP 状态:$f[i][x][y]$ 表示进行 $i$ 次操作,操作后手上剩下的牌为 $x,y$ 的最大得分。转移也不难,枚举下一次新加进来三张后如何选即可。时空复杂度 $O(n^3)$。

仔细想一下,会发现对于相同的 $x,y$,$f[i][x][y]$ 随着 $i$ 的增加永远不会减少,因为最差的情况无非是:每新加三张就把那三张扔掉,永远让 $x,y$ 为手牌,得分永远不会减少。这启发我们考虑 $f[i]\to f[i+1]$ 的变化。

首先,新加入的三张牌 $a,b,c$ 与 $x,y$ 是多少无关,只与当前考虑到哪张牌有关。如果 $a=b=c$,不管 $x,y$ 是多少,一定直接把它扔掉,贪心地立刻得分。正确性容易证明,这里不赘述。接下来考虑不全相等的情况。

如果用上面说的那样“消极”做法,新加入三张牌就扔掉,$f[i+1][x][y]=f[i][x][y]$,这是下限,可以直接从上一维过来,所以只需要考虑哪些 $x,y$ 会发生改变即可。与消极做法相反,要想改变一定要让操作后手牌中有新牌。我们先考虑如何扔牌能造成贡献,再考虑不能造成贡献的情况。

假如三张牌中有两张相等(这里假设是 $a=b$),那么只要 $x,y$ 中有一个与 $a,b$ 相等的牌即可凑起来扔掉,而手牌中的另一张牌与 $c$ 组成新的手牌。此时,我们可以枚举那个“另一张牌”,假设为 $j$,那么有 $f[i][a][j]+1\to f[i+1][j][c]$(这里暂时不考虑两维的手牌的顺序,实现的时候将 $j,c$ 和 $c,j$ 都更改即可)。接下来,考虑两张手牌相等,与另一张相等的新牌配对,可以直接枚举与哪张新牌相等,假设为 $a$,则有 $f[i][a][a]+1\to f[i+1][b][c]$。于是,造成新贡献的考虑完成。

接着考虑不造成新贡献的转移:由于前面说过,新的手牌中必须留新牌,我们可以枚举留哪张新牌,再枚举另一张牌是什么。假设留的新牌是 $a$,另一张牌是 $j$,那么如果 $j=b$ 或 $j=c$,即新的手牌纯用新牌组成,此时旧手牌 $x,y$ 无论是什么都可行。可以维护所有 DP 值的 $\max$。如果 $j$ 不和 $b,c$ 相等,则旧手牌必须有 $j$,我们维护一个数组 $g[j]$ 表示手牌包含 $j$ 的所有 DP 值的 $\max$ 即可。

以上两种转移的次数都是 $O(n)$ 的,接下来说回“继承”:加入三张牌直接扔掉,手牌不变。如果直接枚举 $x,y$,更新 $f[i+1][x][y]=f[i][x][y]$ 的话,复杂度为 $n^2$,所以这里我们偷个懒,省掉第一维 $i$,直接在旧的 $f$ 数组上做修改即可。注意修改必须考虑完所有转移后整体修改,因为原来的转移是 $f[i][x][y]\to f[i+1][x'][y']$,而不能 $f[i+1][x][y]\to f[i+1][x'][y']$。这可以通过 vector 存储 DP 转移实现。具体可以看代码。

#include<bits\/stdc++.h>
using namespace std;
\/\/#define int long long
void chkmax(int &a,int b) {a=a>b?a:b;}
void chkmin(int &a,int b) {a=a<b?a:b;}
int read() {
	int x=0,f=1;char ch=getchar();
	while(!isdigit(ch)) f=(ch=='-'?-1:f),ch=getchar();
	while(isdigit(ch)) x=x*10+ch-'0',ch=getchar();
	return x*f;
}
int a[6010],f[2010][2010],g[2010],mx;
signed main() {
	int n=read(),m=n*3,cnt=0;
	for(int i=1;i<=m;i++)
		a[i]=read();
	memset(f,-0x3f,sizeof(f));
	memset(g,-0x3f,sizeof(g));
	f[a[1]][a[2]]=f[a[2]][a[1]]=0;
	g[a[1]]=g[a[2]]=0,mx=0;
	for(int i=3;i<m;i+=3) {
		array<int,3> p={a[i],a[i+1],a[i+2]};
		sort(p.begin(),p.end());
		if(p[0]==p[2]) {cnt++;continue;}
		vector<pair<pair<int,int>,int> > ch;
		auto add=[&](int x,int y,int val) {
			ch.push_back({{x,y},val});
			ch.push_back({{y,x},val});
		};
		if(p[1]==p[2]) swap(p[0],p[2]);
		if(p[0]==p[1]) {
			for(int i=1;i<=n;i++)
				add(i,p[2],f[i][p[0]]+1);
		}
		for(int i=0;i<3;i++) {
			vector<int> q;
			for(int j=0;j<3;j++)
				if(i!=j) q.push_back(p[j]);
			add(q[0],q[1],f[p[i]][p[i]]+1);
		}
		for(int i=0;i<3;i++) {
			for(int j=1;j<=n;j++) {
				bool flag=0;
				for(int k=0;k<3;k++)
					if(i!=k&&j==p[k]) flag=1;
				if(flag) add(p[i],j,mx);
				else add(p[i],j,g[j]);
			}
		}
		for(auto [x,val]:ch) {
			chkmax(f[x.first][x.second],val);
			chkmax(g[x.first],val),chkmax(g[x.second],val);
			chkmax(mx,val);
		}
	}
	int ans=0;
	for(int i=1;i<=n;i++)
		for(int j=i;j<=n;j++)
			chkmax(ans,f[i][j]+(i==a[m]&&j==a[m]));
	printf("%d\n",ans+cnt);
	return 0;
}

CSP-S2022解题报告

avatar cxm1024 2025-12-01 12:52:19

本文章由 WyOJ Shojo 从洛谷专栏拉取,原发布时间为 2022-11-02 10:59:09

A. 假期计划

题意:有一个无向图,点有点权。定义两个节点“可达”当且仅当这两个节点的最短路不超过 $k+1$。求一组互不相同的节点 $\{a,b,c,d\}$ 使得 $1\leftrightarrow a\leftrightarrow b\leftrightarrow c\leftrightarrow d\leftrightarrow 1$ 每步均可达且这四个点的点权和尽可能大。$n\le 2500$。

首先跑 $n$ 遍 BFS,预处理出每两个点的距离。然后我们可以考虑枚举中间两个节点 $b,c$,处理边上两个节点 $a,d$。首先中间两个节点必须是可达的,否则跳过;然后需要满足 $1\leftrightarrow a\leftrightarrow b$,$c\leftrightarrow d\leftrightarrow 1$。由于“可达”是双向的,我们可以对每个节点 $x$ 预处理出所有满足 $1\leftrightarrow y\leftrightarrow x$ 的节点 $y$ 的集合并按 $y$ 的点权从大到小排序。于是容易想到,当我们枚举了 $b,c$ 时,只需要独立地考虑最大的 $v[a]$ 满足 $1\leftrightarrow a\leftrightarrow b$ 和最大的 $v[d]$ 满足 $1\leftrightarrow d\leftrightarrow c$ 即可。但事实并非如此。有可能对于最大的 $v[a]$,$a=c$,或对于最大的 $v[a],v[d]$,$a=d$,这些都会产生冲突(因为要求互不相同),于是可能需要跳过一些节点。容易证明对于 $b,c$ 只需要考虑前三大的即可,所以乘一个 $9$ 的常数暴力判断。

#include<bits\/stdc++.h>
using namespace std;
#define int long long
int v[2510];
vector<int> a[2510];
bool e[2510][2510];
vector<int> to[2510];
bool vis[2510];
signed main() {
	int n,m,kk;
	scanf("%lld%lld%lld",&n,&m,&kk);
	for(int i=2;i<=n;i++)
		scanf("%lld",&v[i]);
	for(int i=1;i<=m;i++) {
		int x,y;
		scanf("%lld%lld",&x,&y);
		a[x].push_back(y);
		a[y].push_back(x);
	}
	for(int i=1;i<=n;i++) {
		memset(vis,0,sizeof(vis));
		queue<pair<int,int> > q;
		q.push({i,0});
		while(!q.empty()) {
			auto u=q.front();q.pop();
			if(u.second>kk+1) break;
			if(vis[u.first]) continue;
			vis[u.first]=1,e[i][u.first]=1;
			for(int v:a[u.first])
				if(!vis[v]) q.push({v,u.second+1});
		}
	}
	for(int i=2;i<=n;i++) {
		for(int j=2;j<=n;j++)
			if(i!=j&&e[i][j]&&e[1][j])
				to[i].push_back(j);
		sort(to[i].begin(),to[i].end(),[&](int x,int y) {
			return v[x]>v[y];
		});
	}
	int ans=0;
	for(int i=2;i<=n;i++)
		for(int j=i+1;j<=n;j++) {
			if(!e[i][j]) continue;
			for(int k=0;k<min(3ll,(int)to[i].size());k++)
				for(int l=0;l<min(3ll,(int)to[j].size());l++)
					if(to[i][k]!=j&&to[j][l]!=i&&to[i][k]!=to[j][l])
						ans=max(ans,v[i]+v[j]+v[to[i][k]]+v[to[j][l]]);
		}
	printf("%lld\n",ans);
	return 0;
}

B. 策略游戏

题意:给你两个数组 $a(n),b(m)$,每次询问 $l_1,r_1,l_2,r_2$,进行如下博弈:第一个人先选一个 $i\in[l_1,r_1]$,第二个人再选一个 $j\in[l_2,r_2]$,其中第一个人想使 $a_i\cdot b_j$ 最大,第二个人相反。求最终结果。$n,m,q\le 10^5$。

容易发现,此题可以直接分类讨论正负后贪心。如果第一个人选正数,那么第二个人一定会选能选的最小的数。如果第二个人能选到负数则一定会选,此时第一个人选的正数越小越好,否则越大越好。如果第一个人选负数,那么第二个人一定会选最大值。如果第二个人能选到正数则一定会选,此时第一个人选的越大(即越接近 $0$)越好,否则越小越好。

实现上,可以使用线段树维护两个序列的正数最大值、最小值和负数最大值、最小值,每次区间询问合并区间信息即可。

#include<bits\/stdc++.h>
using namespace std;
int a[2][100010];
#define mid (t[now].l+t[now].r)\/2
#define lson now*2
#define rson now*2+1
struct node {
	int l,r,maxp,minp,maxn,minn;
	bool havep,haven;
	node():havep(0),haven(0){}
};
struct segtree {
	node t[400010];
	node merge(node x,node y) {
		node res;
		res.l=x.l,res.r=y.r;
		res.havep=(x.havep||y.havep);
		res.haven=(x.haven||y.haven);
		if(x.havep&&y.havep) {
			res.maxp=max(x.maxp,y.maxp);
			res.minp=min(x.minp,y.minp);
		}
		else if(x.havep||y.havep) {
			res.maxp=x.maxp*x.havep+y.maxp*y.havep;
			res.minp=x.minp*x.havep+y.minp*y.havep;
		}
		if(x.haven&&y.haven) {
			res.maxn=max(x.maxn,y.maxn);
			res.minn=min(x.minn,y.minn);
		}
		else if(x.haven||y.haven) {
			res.maxn=x.maxn*x.haven+y.maxn*y.haven;
			res.minn=x.minn*x.haven+y.minn*y.haven;
		}
		return res;
	}
	void build(int now,int l,int r,bool flag) {
		t[now].l=l,t[now].r=r;
		if(l==r) {
			if(a[flag][l]>=0) {
				t[now].havep=1;
				t[now].maxp=t[now].minp=a[flag][l];
			}
			else {
				t[now].haven=1;
				t[now].maxn=t[now].minn=a[flag][l];
			}
			return;
		}
		build(lson,l,mid,flag);
		build(rson,mid+1,r,flag);
		t[now]=merge(t[lson],t[rson]);
	}
	node query(int now,int l,int r) {
		if(l<=t[now].l&&r>=t[now].r) return t[now];
		node res;
		if(l<=mid) res=merge(res,query(lson,l,r));
		if(r>mid) res=merge(res,query(rson,l,r));
		return res;
	}
} T1,T2;
void chkmax(long long &x,long long y) {x=(x>y)?x:y;}
int main() {
	int n,m,q;
	scanf("%d%d%d",&n,&m,&q);
	for(int i=1;i<=n;i++)
		scanf("%d",&a[0][i]);
	for(int i=1;i<=m;i++)
		scanf("%d",&a[1][i]);
	T1.build(1,1,n,0);
	T2.build(1,1,m,1);
	while(q--) {
		int l1,r1,l2,r2;
		scanf("%d%d%d%d",&l1,&r1,&l2,&r2);
		node A=T1.query(1,l1,r1);
		node B=T2.query(1,l2,r2);
		long long ans=-1e18;
		if(A.havep) {
			if(B.haven) chkmax(ans,1ll*A.minp*B.minn);
			else chkmax(ans,1ll*A.maxp*B.minp);
		}
		if(A.haven) {
			if(B.havep) chkmax(ans,1ll*A.maxn*B.maxp);
			else chkmax(ans,1ll*A.minn*B.maxn);
		}
		printf("%lld\n",ans);
	}
	return 0;
}

C. 星战

题意:有一张简单的有向图(不保证连通),每条边有可用和不可用两种状态,初始每条边都可用。定义一个图是合法的,当且仅当:

  1. 从每个点开始都存在一个合适的移动方式使得能够无限移动下去。
  2. 每个点有且仅有一条出边。

你需要进行 $q$ 次操作,每次如下:

  1. 给出 $u,v$,将 $u\to v$ 变为不可用。保证此前处于可用状态。
  2. 给出 $u$,将所有 $x\to u$ 全部变为不可用。
  3. 给出 $u,v$,将 $u\to v$ 变为可用。保证此前处于不可用状态。
  4. 给出 $u$,将所有 $x\to u$ 全部变为可用。

每次操作后回答这张图是否合法。$n,m,q\le 5\times 10^5$。

可以发现,合法的限制一是没有用的。因为如果满足了限制二,该有向图一定为一个基环内向树森林,于是每个节点必然可以通向一个环。可以通过反证法简单地证明:如果存在某个点不能无限移动下去,设它的终点为 $x$,根据限制二,$x$ 必然有出边,故不能成为终点,与假设矛盾。

于是问题转化为每次操作后判断是否每个点的出度均为 $1$。

我们考虑通过哈希来维护这一过程。我们给每个点赋一个随机权值,维护当前每条边起点的权值和 $nowsum$ 并预处理所有点的权值和 $all$。此时如果 $nowsum=all$ 等于每个点的权值和,我们就可以认为每个点恰有一个出边。

对于暴力连边和断边的操作,可以直接在 $nowsum$ 上加减。但是对于断点和恢复点的操作我们没法维护。所以考虑增加维护的状态。定义 $now_i$ 为当前可用的、以 $i$ 为终点的所有起点权值和;$sum_i$ 为所有(包括不可用)以 $i$ 为终点的起点权值和。于是,最终方案如下:

  1. 暴力连断边:根据定义,$nowsum$ 增/减 $x$ 的权值,$now_y$ 同样增/减 $x$ 的权值。
  2. 删点、恢复点:使用 $now_x$ 和 $sum_x$ 计算出 $nowsum$ 需要改变的值,更新即可。

可以感性理解成势能和动能的转化:$now_i$ 维护每个终点的势能(即其起点的权值和),势能越大,删掉该点时 $nowsum$ 就会减少更多。连边和断边相当于直接更改其终点的势能,而连点和断点相当于将其势能归零/回满。

#include<bits\/stdc++.h>
using namespace std;
long long a[500010],sum[500010],now[500010];
signed main() {
	srand(time(0));
	int n,m,q;
	scanf("%d%d",&n,&m);
	long long nowsum=0,all=0;
	for(int i=1;i<=n;i++) a[i]=rand(),all+=a[i];
	for(int i=1;i<=m;i++) {
		int x,y;
		scanf("%d%d",&x,&y);
		sum[y]+=a[x],now[y]+=a[x],nowsum+=a[x];
	}
	scanf("%d",&q);
	while(q--) {
		int op,x,y;
		scanf("%d%d",&op,&x);
		if(op==1||op==3) scanf("%d",&y);
		if(op==1) now[y]-=a[x],nowsum-=a[x];
		else if(op==2) nowsum-=now[x],now[x]=0;
		else if(op==3) now[y]+=a[x],nowsum+=a[x];
		else nowsum+=sum[x]-now[x],now[x]=sum[x];
		if(nowsum==all) puts("YES");
		else puts("NO");
	}
	return 0;
}

D. 数据传输

题意:给你一个树,第 $i$ 个点有点权 $v_i(>0)$,定义一次跳跃是合法的,当且仅当跳跃的两个节点的距离不超过 $k$。每次询问给出两个节点 $s,t$,你需要考虑一个从 $s$ 走到 $t$ 的方案 $s\to c_1\to c_2\to\cdots\to t$ 使得每步跳跃都合法。输出经过的点的最小点权和(即 $\min\limits_c\{s+\sum c+t\}$)。$n,q\le 2\times 10^5,k\le 3$。

首先考虑最简单的 $k=1$ 的情况。此时每步跳跃只能沿着边走,所以答案即为路径上的点权和。可以使用 LCA 和树上差分计算。

对于 $k=2$,我们可以把路径拉出来,每次跳一步或跳两步,通过简单的 $O(n)$ DP 来计算答案(虽然复杂度不可行)。考虑这个做法的正确性:一定是在两点间路径上跳吗?答案是一定的。如果不在两点间路径上跳,情况一定如下图:
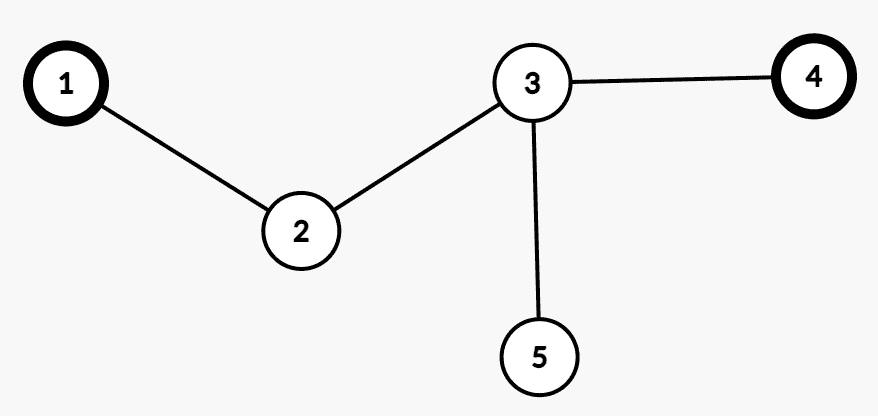
我们可以从 $2$ 跳到 $5$ 再跳到 $4$,但这样一定不如从 $2$ 直接跳到 $4$ 优。

对于 $k=3$,情况就变得麻烦多了。此时跳到路径外变得可行了,如下图:
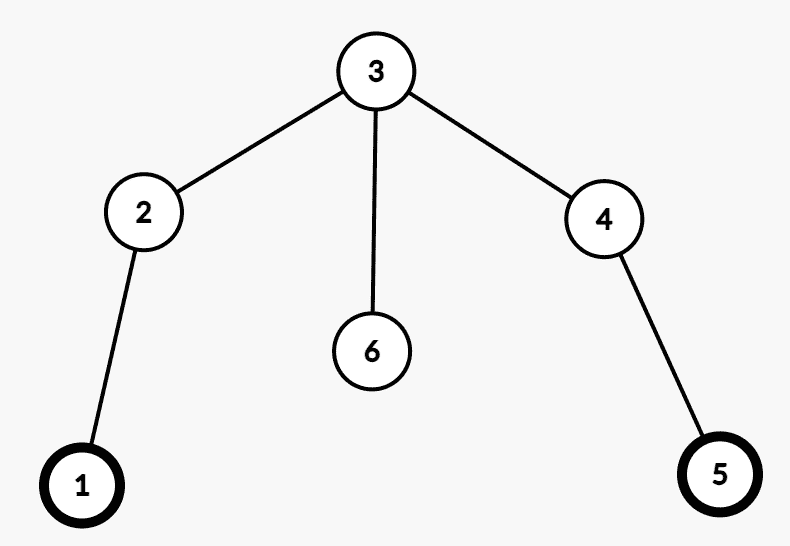
此时如果点 $6$ 的权值比 $2,3,4$ 小,那么最优策略将是 $1\to 6\to 5$。这就导致了我们上一节的 DP 变得不可行。我们考虑加强上面的过程。这次不只是单独把这一条链拉出来,还要把这条链周围一格的点也拉出来一起考虑。容易证明,这条链周围两格的节点是没有考虑的意义的,证明与上面 $k=2$ 链外无意义类似。

然后我们考虑扩展 DP 状态:定义 $f[i][j\in\{0,1,2\}]$ 表示只考虑链上前 $i$ 个点及其周围一格的点,而当前跳到了一个距离 $i$ 为 $j$ 的点上的最小代价。接着考虑转移:

$f[i][0]$。此时就在第 $i$ 个节点本身。可以从第 $i-1$ 个节点本身转移而来,也可以从“与第 $i-1$ 个节点距离为 $1$ 的节点”转移而来(此时需要跳两格),也可以从“与第 $i-1$ 个节点距离为 $2$ 的节点”转移而来(此时需要跳三格)。故:$f[i][0]=\min(f[i-1][0]+v_i,f[i-1][1]+v_i,f[i-1][2]+v_i)$。

$f[i][1]$。此时我们在“与第 $i$ 个节点距离为 $1$ 的节点”上。这有哪些可能性呢?如下图:

此时当前所在的位置有 $i-1,a,b,i+1$ 四种可能性。对于在 $i-1$ 的情况,可以由 $f[i-1][0]$ 转移过来(即保持不动);对于其他情况,我们只能从 $c$ 或 $i-2$(与 $i-1$ 距离为 $1$ 的点)转移,而不能从 $i-1$ 本身转移。这是因为,如果我们从 $i-1\to a$,下一步往上跳一格后往右至多跳两格,而此时可以直接从 $i-1$ 跳三格过去更优,所以不应从 $i-1\to a$。综上,$f[i][1]=\min(f[i-1][0],f[i-1][1]+mn_i)$,其中 $mn_i$ 为 $i$ 节点的邻居中最小的点权(都在 $i$ 周围的点没有本质区别,自然权值越小越好)。$mn$ 可以预处理出来。

$f[i][2]$。此时在 $c$ 或 $i-2$,距离 $i-1$ 为 $1$,所以直接由 $f[i-1][1]$ 转移而来。$f[i][2]=f[i-1][1]$。

结合以上分析,我们得到了如下的 DP 方程:

$$ \begin{aligned} f[i][0]&=\min(f[i-1][0]+v_i,f[i-1][1]+v_i,f[i-1][2]+v_i)\ f[i][1]&=\min(f[i-1][0],f[i-1][1]+mn_i)\ f[i][2]&=\min(f[i-1][1]) \end{aligned} $$

(最后一个为了统一格式也用 $\min$)容易发现,$f[i]$ 的三个状态完全由 $f[i-1]$ 的三个状态以及其他仅与 $i$ 有关的贡献转移而来。我们可以想到使用矩阵来优化这一步骤。我们新定义一个矩阵乘法:$[A\cdot B]{i,j}=\min\limits_k\{A{i,k}+B_{k,j}\}$。此矩阵乘法同样具有结合律:

$$ \begin{aligned} [A\cdot (B\cdot C)]{i,j}&=\min\limits_k\{A{i,k}+[B\cdot C]{k,j}\}\ &=\min\limits_k\left\{A{i,k}+\min\limits_p\{B_{k,p}+C_{p,j}\}\right\}\ &=\min\limits_k\left\{\min\limits_p\{A_{i,k}+B_{k,p}+C_{p,j}\}\right\}\ &=\min\limits_p\left\{\min\limits_k\{A_{i,k}+B_{k,p}+C_{p,j}\}\right\}\ &=\min\limits_p\left\{\min\limits_k\{A_{i,k}+B_{k,p}\}+C_{p,j}\right\}\ &=\min\limits_p\{[A\cdot B]{i,p}+C{p,j}\}\ &=[(A\cdot B)\cdot C]_{i,j} \end{aligned} $$

这是一个经典的矩阵乘法的定义:内层相加,外层极值。于是,我们可以把 DP 转移转化为下面的矩阵乘法:

$$ \begin{bmatrix} f[i][0] & f[i][1] & f[i][2] \end{bmatrix}

\begin{bmatrix} f[i-1][0] & f[i-1][1] & f[i-1][2] \end{bmatrix} \cdot \begin{bmatrix} v_i & 0 & +\infty\ v_i & mn_i & 0\ v_i & +\infty & +\infty \end{bmatrix} $$

在 $k=2$ 时也类似,转移矩阵稍微改变一下即可。将 DP 变为矩阵的转化直接使得在每个点的转移变得独立,而与具体路径完全无关。

由于结合律,问题转化为求路径上每个节点的矩阵乘积。由于树上的路径可以分为向上的一段和向下的一段,我们考虑倍增求树上 ST 表。定义 $g[i][j]$ 为一个矩阵,表示从第 $i$ 个点开始,往上连续 $2^j$ 个点的矩阵乘积,可以在预处理 LCA 时顺便完成 $g$ 的预处理。同时,定义 $h[i][j]$ 与 $g[i][j]$ 类似,只不过保存的是从上往下乘的结果。最终答案即为向上的总转移矩阵乘向下的总转移矩阵,再乘 $s$ 时的初始状态,使用树上倍增即可。时间复杂度 $qn\log(n)\times k^3$。

#include<bits\/stdc++.h>
using namespace std;
#define int long long
int n,q,k,v[200010];
struct matrix {
	int n,a[3][3];
	matrix operator*(matrix o) {
		matrix res;
		res.n=n;
		for(int i=0;i<n;i++)
			for(int j=0;j<n;j++) {
				res.a[i][j]=1e18;
				for(int k=0;k<n;k++)
					res.a[i][j]=min(res.a[i][j],a[i][k]+o.a[k][j]);
			}
		return res;
	}
} f[200010][20],g[200010][20];
vector<int> e[200010];
int fa[200010][20],mn[200010],dep[200010];
void dfs(int now,int father,int depth) {
	fa[now][0]=father,dep[now]=depth;
	f[now][0].n=k;
	auto &t=f[now][0].a;
	for(int i=0;i<3;i++)
		t[i][0]=v[now];
	t[0][1]=t[1][2]=0;
	t[1][1]=mn[now];
	t[2][1]=t[0][2]=t[2][2]=1e18;
	if(k==2) t[1][1]=1e18;
	g[now][0]=f[now][0];
	for(int to:e[now])
		if(to!=father) dfs(to,now,depth+1);
}
int LCA(int x,int y) {
	if(dep[x]<dep[y]) swap(x,y);
	for(int i=19;i>=0;i--)
		if(dep[fa[x][i]]>=dep[y])
			x=fa[x][i];
	if(x==y) return x;
	for(int i=19;i>=0;i--)
		if(fa[x][i]!=fa[y][i])
			x=fa[x][i],y=fa[y][i];
	return fa[x][0];
}
signed main() {
	memset(mn,0x3f,sizeof(mn));
	scanf("%lld%lld%lld",&n,&q,&k);
	matrix init;
	init.n=k;
	for(int i=0;i<k;i++)
		for(int j=0;j<k;j++)
			init.a[i][j]=(i!=j)*1e18;
	for(int i=1;i<=n;i++)
		scanf("%lld",&v[i]);
	for(int i=1;i<n;i++) {
		int x,y;
		scanf("%lld%lld",&x,&y);
		e[x].push_back(y);
		e[y].push_back(x);
		mn[x]=min(mn[x],v[y]);
		mn[y]=min(mn[y],v[x]);
	}
	dfs(1,0,1);
	for(int x=0;x<=19;x++)
		f[0][x]=g[0][x]=init;
	for(int j=1;j<=19;j++)
		for(int i=1;i<=n;i++) {
			fa[i][j]=fa[fa[i][j-1]][j-1];
			f[i][j]=f[i][j-1]*f[fa[i][j-1]][j-1];
			g[i][j]=g[fa[i][j-1]][j-1]*g[i][j-1];
		}
	while(q--) {
		int s,t;
		scanf("%lld%lld",&s,&t);
		int lca=LCA(s,t),x=v[s];
		s=fa[s][0];
		matrix tmp1=init,tmp2=init;
		for(int i=19;i>=0&&s;i--)
			if(dep[fa[s][i]]+1>=dep[lca])
				tmp1=tmp1*f[s][i],s=fa[s][i];
		for(int i=19;i>=0&&t;i--)
			if(dep[fa[t][i]]>=dep[lca])
				tmp2=g[t][i]*tmp2,t=fa[t][i];
		matrix ans=tmp1*tmp2;
		printf("%lld\n",ans.a[0][0]+x);
	}
	return 0;
}

儒略日-题解

avatar cxm1024 2025-12-01 12:52:19

本文章由 WyOJ Shojo 从洛谷专栏拉取,原发布时间为 2022-07-07 11:44:16

前言

时隔两年,这个极为经典的题目终于被我 AC 了。经过诸多优化改良,最终得到了这个个人认为比较优美的做法,写篇题解纪念一下,也供参考。

首先,建议读者先对照无注释代码自行理解一下大致过程。

无注释代码

#include<bits\/stdc++.h>
using namespace std;
#define int long long
const int mon[13]={0,31,28,31,30,31,30,31,31,30,31,30,31};
const int _1=365,_100=_1*100+24,_400=_100*4+1;
struct date{int y,m,d,ru;} t[4000010];
bool isrun(int year) {
	if(year<0) return (year+1)%4==0;
	return year%4==0&&(year<=1582||year%100!=0||year%400==0);
}
date nxtday(date a) {
	a.d++,a.ru++;
	if(a.y==1582&&a.m==10&&a.d==5) return a.d=15,a;
	if(a.m==2&&a.d==29&&isrun(a.y));
	else if(a.d>mon[a.m]) a.m++,a.d=1;
	if(a.m>12) a.y++,a.y+=!a.y,a.m=1;
	return a;
}
void print(date x) {
	cout<<x.d<<" "<<x.m<<" "<<abs(x.y)<<(x.y<0?" BC":"")<<endl;
}
signed main() {
	t[0]={-4713,1,1,0};
	int _20000101;
	for(int i=1;t[i-1].y<=2000;i++) {
		t[i]=nxtday(t[i-1]);
		if(t[i].y==2000&&t[i].m==1&&t[i].d==1)
			_20000101=t[i].ru;
	}
	int _0=_20000101-_400*5,T,x;
	cin>>T;
	while(T--) {
		cin>>x;
		if(x<=_20000101) print(t[x]);
		else {
			date ans{(x-_0)\/_400*400,1,1,(x-_0)\/_400*_400+_0};
			while(ans.ru+_100+isrun(ans.y)<=x)
				ans.ru+=_100+isrun(ans.y),ans.y+=100;
			while(ans.ru+_1+isrun(ans.y)<=x)
				ans.ru+=_1+isrun(ans.y),ans.y++;
			while(ans.ru<x) ans=nxtday(ans);
			print(ans);
		}
	}
	return 0;
}

解析

大体思路是这样的:$1582$ 年之前的暴力 nxtday 跑出来,而 $1582$ 年之后的想办法逐渐逼近计算。

这里我们暴力跑到了 $2000$ 年(以下讲解只考虑 $2000$ 年以后),并保存了 _20000101 这个常数,表示 $2000$ 年 $1$ 月 $1$ 日的儒略日。原因之一是避免考虑边界情况,而原因之二,就是本做法的灵魂所在:

重点在于 _20000101 这个常数。将这个常数减去五个 $400$ 年(代码中的 _400),就可以反推出“理想状态下”公元 $0$ 年 $1$ 月 $1$ 日的儒略日 _0。这样,我们就可以 $O(1)$ 计算出所求儒略日位于哪一个“$400$ 年周期”中,并得到该周期的第一天的确切 date:

  • year=(x-_0)\/_400*400
  • ru=(x-_0)\/_400*_400+_0

这两行为本 trick 的精华,建议仔细理解(见程序第 36 行)

求出了本周期第一天的儒略日,接下来就是简单的逼近答案了:先尝试每次加上 $100$ 年(不超过 $4$ 次),再每次加上 $1$ 年(不超过 $100$ 次),最后暴力 nxtday 跑到答案(不超过 $365$ 次)。时间复杂度在可接受范围之内。

详细代码

#include<bits\/stdc++.h>
using namespace std;
#define int long long
const int mon[13]={0,31,28,31,30,31,30,31,31,30,31,30,31};
const int _1=365,_100=_1*100+24,_400=_100*4+1;
\/\/方便计算,预处理出格里高利历1年、100年和400年的天数
struct date{int y,m,d,ru;} t[4000010];
\/\/公元前的y为负数
bool isrun(int year) { \/\/闰年判断
	if(year<0) return (year+1)%4==0;
	return year%4==0&&(year<=1582||year%100!=0||year%400==0);
}
date nxtday(date a) { \/\/暴力计算下一天
	a.d++,a.ru++; \/\/天数和儒略日首先增加
	if(a.y==1582&&a.m==10&&a.d==5) return a.d=15,a;
	\/\/特判中间消失的10天
	if(a.m==2&&a.d==29&&isrun(a.y)); \/\/闰年的2月29无需进位
	else if(a.d>mon[a.m]) a.m++,a.d=1; \/\/由日向月进位
	if(a.m>12) a.y++,a.y+=!a.y,a.m=1; \/\/由月向年进位(特判了公元0年不存在)
	return a;
}
void print(date x) { \/\/输出
	cout<<x.d<<" "<<x.m<<" "<<abs(x.y)<<(x.y<0?" BC":"")<<endl;
}
signed main() {
	t[0]={-4713,1,1,0};
	int _20000101;
	for(int i=1;t[i-1].y<=2000;i++) { \/\/暴力打表到2000年
		t[i]=nxtday(t[i-1]);
		if(t[i].y==2000&&t[i].m==1&&t[i].d==1)
			_20000101=t[i].ru; \/\/保存常数2000.1.1儒略日
	}
	int _0=_20000101-_400*5,T,x; \/\/计算“理想状态”下0.1.1儒略日
	cin>>T;
	while(T--) {
		cin>>x;
		if(x<=_20000101) print(t[x]); \/\/直接查表
		else {
			date ans{(x-_0)\/_400*400,1,1,(x-_0)\/_400*_400+_0};
			\/\/计算400周期的第一天(格式为y,m,d,ru)
			while(ans.ru+_100+isrun(ans.y)<=x)
				ans.ru+=_100+isrun(ans.y),ans.y+=100;
			\/\/100年为步长逼近
			while(ans.ru+_1+isrun(ans.y)<=x)
				ans.ru+=_1+isrun(ans.y),ans.y++;
			\/\/1年为步长逼近
			while(ans.ru<x) ans=nxtday(ans);
			\/\/暴力nxtday得到答案
			print(ans);
		}
	}
	return 0;
}

奇怪的勾股定理证明方法

avatar cxm1024 2025-12-01 12:52:19

本文章由 WyOJ Shojo 从洛谷专栏拉取,原发布时间为 2022-04-28 16:47:19

更好的阅读体验

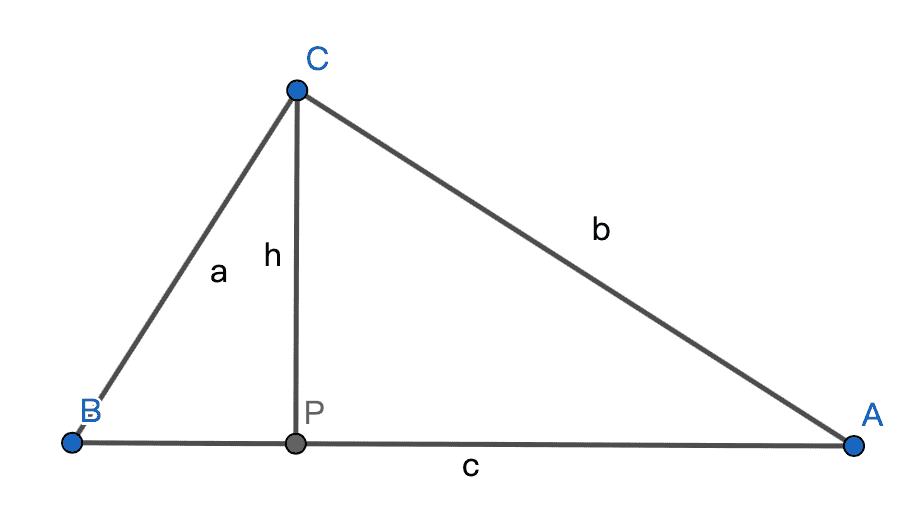
在这个直角三角形中,我们设以 $c$ 为底的大三角形面积为 $S_c$,以 $a,b$ 为底的两个小三角形的面积分别为 $S_a,S_b$。

显然,$S_c=\frac{ch}{2}=c^2\cdot\frac{h}{2c}$。我们设 $\frac{h}{2c}=m$,则有 $S_c=mc^2$。

同理,$S_a=a^2\cdot\frac{h_a}{2a}$(其中 $h_a$ 表示三角形 $BPC$ 中以 $a$ 为底的高)。显然该三角形与大三角形 $ABC$ 相似,所以 $\frac{h_a}{2a}=\frac{h}{2c}=m$,所以 $S_a=ma^2$。同理 $S_b=mb^2$。

又因为,$S_c=S_a+S_b$,所以 $mc^2=ma^2+mb^2$,即 $c^2=a^2+b^2$。

P1177快速排序 题解

avatar cxm1024 2025-12-01 12:52:18

本文章由 WyOJ Shojo 从洛谷专栏拉取,原发布时间为 2022-03-09 11:24:53

众所周知,A+B Problem 的题解里充斥着各种奇奇怪怪的做法,那为什么这道题没有呢?于是就有了这篇题解。

1.set大法好

我们都知道,STL 有 sort 和 priority_queue 给我们用,但却很少人想到 set 也是可以排序的。由于有重复元素,所以这里使用 multiset。

#include<bits\/stdc++.h>
using namespace std;
int main() {
	int n,x;
	multiset<int> s;
	cin>>n;
	while(n--) {cin>>x;s.insert(x);}
	for(int t:s) cout<<t<<" ";
	return 0;
}

虽然非常“巧妙”,但是这使用了 STL,违背了题目要求,于是:

2.桶排序

我们都知道,桶排序是非常快的,只需要 $O(N)$ 的时间和 $O(a_i)$ 的空间,然而这题 $a_i$ 最大到了 $10^9$,面对这种情况,最常见的选择就是是离散化(迫真)。于是,我们先对数组离散化一下,再把数组中元素的离散化结果扔到桶里面,最后扫一遍桶中元素即可。

#include<bits\/stdc++.h>
using namespace std;
int n,a[100010],b[100010],cnt=0;
int t[100010];
int main() {
	cin>>n;
	for(int i=1;i<=n;i++) {
		cin>>a[i];
		b[++cnt]=a[i];
	}
	sort(b+1,b+cnt+1);
	cnt=unique(b+1,b+cnt+1)-b-1;
	for(int i=1;i<=n;i++) {
		int tmp=lower_bound(b+1,b+cnt+1,a[i])-b;
		t[tmp]++;
	}
	for(int i=1;i<=cnt;i++)
		while(t[i]--)
			cout<<b[i]<<" ";
	cout<<endl;
	return 0;
}

你可能会问:这不是还是需要 sort 吗?没错,但你还是不能否认桶排序就是快(实际上,这是本篇题解中最快的做法了)。

但是,使用了 sort 确实违背了题目要求,于是:

3.动态开点权值线段树

这题不是显然可以用权值线段树做吗。。。由于数据范围比较大,要么离散化要么动态开点。如果离散化,就需要 sort,这违背了我们的初衷,所以我们使用动态开点。

首先依次加入 $n$ 个数,接下来每次询问排名为 $i$ 的数即可,时间复杂度 $O(nlog(n))$。

#include<bits\/stdc++.h>
using namespace std;
const int inf=1e9;
int n,tot=0,root;
struct tree{int num,l,r,lson,rson;} t[2000010];
#define mid (t[now].l+t[now].r)\/2
int newnode(int l,int r) {
	t[++tot].l=l,t[tot].r=r;
	return tot;
}
void change(int &now,int x,int l=-inf,int r=inf) {
	if(!now) now=newnode(l,r);
	if(l!=r) {
		if(x<=mid) change(t[now].lson,x,l,mid);
		else change(t[now].rson,x,mid+1,r);
	}
	t[now].num++;
}
int search(int now,int k) {
	if(t[now].l==t[now].r) return t[now].l;
	int val=t[t[now].lson].num;
	if(k<=val) return search(t[now].lson,k);
	else return search(t[now].rson,k-val);
}
int main() {
	cin>>n;
	for(int i=1;i<=n;i++) {
		int x;
		cin>>x;
		change(root,x);
	}
	for(int i=1;i<=n;i++)
		cout<<search(root,i)<<" ";
	cout<<endl;
	return 0;
}

这种做法非常完美的满足了题目的要求:不用任何 STL。完结撒花!

背包DP学习笔记

avatar cxm1024 2025-12-01 12:52:18

本文章由 WyOJ Shojo 从洛谷专栏拉取,原发布时间为 2022-01-22 14:31:18

01背包

由于01背包太过经典,所以一定要把每一个细节理解透彻!

有 $n$ 个物品和一个容量为 $m$ 的背包,每个物品有体积 $w_i$ 和价值 $v_i$,求用这个背包所能装下的最大价值。

设 $f_{i,j}$ 表示只考虑前 $i$ 个物品,体积不超过 $j$ 的最大价值。如果我们算完了前 $i-1$ 个物品的所有结果,那么第 $i$ 个物品有选和不选两种情况。如果不选,则结果为 $f_{i-1,j}$;如果买,则:由于选了 $i$ 后体积不超过 $j$,那么选 $i$ 之前体积就不能超过 $j-w_i$,而选了 $i$ 之后获得的价值就多了 $v_i$,所以结果为 $f_{i-1,j-w_i}+v_i$。这样,我们就得出了经典的状态转移方程:$f_{i,j}=max(f_{i-1,j},f_{i-1,j-w_i}+v_i)$。

接下来,我们再考虑一些细节。对于 $f$ 数组的初始化,我们可以将所有的方案全部赋值为 $0$,因为无论考虑多少物品,无论体积不超过多少,都一定有一种符合要求的方案:一个也不选。这时的价值就是 $0$。

然后就到了经典的空间优化:我们可以发现 $f_i$ 这一行只与 $f_{i-1}$ 这一行有关,所以我们可以将 $i$ 这一维省略。这样,当我们准备求 $f_j$ 时,我们要求 $f_j$ 和 $f_{j-w_i}$ 都还没有被更新过。因为我们正准备更新 $f_j$,所以第一个要求可以保证,那么怎么保证 $f_{j-w_i}$ 没有被更新过呢?答案就是倒序更新(这样就在更新 $f_j$ 之后才会更新到 $f_{j-w_i}$ 了)。

接下来还有一个经典的常数优化:因为当 $j<w_i$ 时,转移方程中 $f_{j-w_i}$ 不存在,不需要考虑更新,所以 $j$ 必须大于等于 $w_i$,也就是倒序枚举时 $j$ 只需要从 $m$ 枚举到 $w_i$。

所以,我们就得到了经典的01背包代码:

for(int i=1;i<=n;i++)
	for(int j=m;j>=w_i;j--)
		f[j]=max(f[j],f[j-w[i]]+v[i]);
cout<<f[m]<<endl;

例题:采药

正好填满的01背包

是一个01背包经典的变形,题意基本与01背包相同,但要求背包必须填满。

这时,$f$ 数组的意义发生了一点变化:$f_{i,j}$ 表示只考虑前 $i$ 个物品,体积恰好为 $j$ 的最大价值。

但是,仔细推理一下,就会发现,状态转移方程和01背包一模一样,空间优化和常数优化也都通用。那不一样的地方在哪里呢?答案是初始化。由于要求体积恰好为 $j$,所以当 $j\ne 0$ 时,不允许一个也不选,所以初始化为负无穷(表示目前没有任何方案满足条件),当 $j=0$ 时,才存在一个也不选的方案,这时才能初始化为 $0$。

代码:

memset(f,-0x3f,sizeof(f));
f[0]=0;
for(int i=1;i<=n;i++)
	for(int j=m;j>=w[i];j--)
		f[j]=max(f[j],f[j-w[i]]+v[i]);
cout<<f[m]<<endl;

二维费用背包

有两维费用(如:一个事件既要消耗时间也要消耗金钱,获得一定价值)的01背包。

将01背包多开两维费用,其他完全相同。

代码:

\/\/背包第一维容量为m,背包第二维容量为t
for(int i=1;i<=n;i++)
	for(int j=m;j>=w1[i];j--)
		for(int k=t;k>=w2[i];k--)
			f[j][k]=max(f[j][k],f[j-w1[i]][k-w2[i]]+v[i]);
cout<<f[m][t]<<endl;

例题:榨取kkksc03

完全背包

又是一个经典模型,也必须要理解透彻。题意与01背包基本相同,但每个物品能选无数遍。

同样设 $f_{i,j}$ 表示只考虑前 $i$ 种物品,体积不超过 $j$ 的最大价值。这时如何更新呢?如果我们不选这个物品,那么结果为 $f_{i-1,j}$;如果选,那么结果为 $f_{i,j-w_i}+v_i$。这是为什么呢?在01背包中,我们当前要选 $i$,那么选这个 $i$ 之前,只能考虑前 $i-1$ 个物品,所以要从 $f_{i-1,j-w_i}$ 转移,但是在完全背包中,每个物品可以选无数次,所以选这个 $i$ 之前,$i$ 也是可以选的,所以要从 $f_{i,j-w_i}$ 转移而来。这样,我们就得到了最终的转移方程:$f_{i,j}=max(f_{i-1,j},f_{i,j-w_i}+v_i)$。

同01背包一样,我们也可以省略掉 $i$ 这一维。这时,当我们求 $f_j$ 时,要求变成 $f_j$ 还没有更新,而 $f_{j-w_i}$ 已经更新过了(因为我们要用的是 $f_{i,j-w_i}$ 而不是 $f_{i-1,j-w_i}$)。同样,第一个要求能直接满足,对于第二个要求,我们只需要正序枚举 $j$ 即可。所以,最终转移方程与01背包一样,但 $j$ 的枚举顺序变成了正序。

代码:

for(int i=1;i<=n;i++)
	for(int j=w[i];j<=m;j++)
		f[j]=max(f[j],f[j-w[i]]+v[i]);
cout<<f[m]<<endl;

例题:疯狂的采药

多重背包

题意与01背包基本相同,但每种物品能选 $x_i$ 次。

一个很容易想到的思路为将一种物品选 $x$ 次转换成 $x$ 个完全相同的物品,再做01背包。

这样的复杂度显然不够优秀,所以我们考虑优化。我们希望将每个物品选 $x$ 次转换成若干个物品,使得无论想选多少次都能用这若干个物品凑出来。一个较为明显的做法就是二进制分解。例如,我们有一个物品能选20次,我们就将它分解成一个 $1$ 倍物品、一个 $2$ 倍物品、一个 $4$ 倍物品、一个 $8$ 倍物品和一个 $5$ 倍物品(几倍物品指的是体积和价值都为原物品的几倍)。易证,这一定满足我们的条件。这样,我们就将一个物品选 $x$ 次分解成了 $\log(x)$ 个物品,然后再跑一遍01背包即可。

代码:

for(int i=1;i<=n;i++)
	for(int tmp=1;x[i];tmp*=2) {
		int num=min(tmp,x[i]);
		int wt=w[i]*num,vt=v[i]*num;
		for(int j=m;j>=wt;j--)
			f[j]=max(f[j],f[j-wt]+vt);
		x[i]-=num;
	}
cout<<f[m]<<endl;

例题:宝物筛选

混合背包

将01背包、完全背包和多重背包缝合在一起的问题。

思路很简单,无需多讲解,分别考虑即可。形式为:

for(枚举物品)  {
	if(01背包)
		01背包代码
	else if(完全背包)
		完全背包代码
	else
		多重背包代码
}

实际上,01背包和多重背包可以共用多重背包的代码,因为01背包可以当成只能取一次的多重背包。

例题:樱花

核心代码:

for(int i=1;i<=n;i++) {
	if(x[i]==0) {\/\/完全背包
		for(int j=w[i];j<=m;j++)
			f[j]=max(f[j],f[j-w[i]]+v[i]);
	}
	else {\/\/01背包和多重背包
		for(int tmp=1;x[i];tmp*=2) {
			int num=min(tmp,x[i]);
			int wt=w[i]*num,vt=v[i]*num;
			for(int j=m;j>=wt;j--)
				f[j]=max(f[j],f[j-wt]+vt);
			x[i]-=num;
		}
	}
}
cout<<f[m]<<endl;

至此,基本模型已经讲完,希望读者能把每一个步骤都理解透彻!

谢谢观看

P3383【模板】线性筛 题解

avatar cxm1024 2025-12-01 12:52:18

本文章由 WyOJ Shojo 从洛谷专栏拉取,原发布时间为 2021-10-21 15:42:57

这道题是线性筛的模板题,所以我们考虑怎么不用线性筛。

我们都知道有一种筛法叫埃拉托色尼筛,简称埃氏筛,它比线性筛好写,也更好理解,但它过不了这道题,那怎么办呢?我们可以用 $bitset$ 代替 bool 数组来进行优化,这造成的常数优化非常显著,以至于开了 ios::sync_with_stdio(false) 之后能轻松过掉这道题,和线性筛的时间总差距只有 $0.5s$,可以说是非常优秀了。

AC 代码:

#include<bits\/stdc++.h>
using namespace std;
const int MAXN=100000000;
int cnt=0,prime[6000000];
bitset<100000000> p;
void init() {
	p.flip();p[1]=0;
	for(int i=2;i<MAXN;i++) {
		if(p[i]) {
			prime[++cnt]=i;
			for(int j=i+i;j<MAXN;j+=i)
				p[j]=0;
		}
	}
}
int main() {
    ios::sync_with_stdio(false);
	init();
	int n;
	cin>>n>>n;
	while(n--) {
		int x;
		cin>>x;
		cout<<prime[x]<<endl;
	}
	return 0;
}

EDU-CFR-53(Div.2)解题报告

avatar cxm1024 2025-12-01 12:52:18

本文章由 WyOJ Shojo 从洛谷专栏拉取,原发布时间为 2021-10-14 15:50:48

更好的阅读体验

A. Diverse Substring

$Problem$

定义一个字符串为多变的,当且仅当字符串中没有一个字符的出现次数严格大于 $n/2$。给定一个只由小写字母构成的字符串,问是否能找出一个多变的字串,如果能,任意输出一个。

$n\le 1000$

$Solution$

只有两个不同字符的字符串时多变的,所以只要给定的字符串中包含至少两个字符就一定可以,输出相邻两个不同字符即可。

B. Vasya and Books

$Problem$

有一摞书,从上到下依次编号为 $a_1,a_2,a_3...$,现在 Vasya 想把它们分 $n$ 次挪到别的地方,每次他会告诉你他想挪的书的编号,如果这本书还没有被挪动,他将会把这本书以上的书(包括这本书)一块搬走。对于每次挪动,回答他搬了多少本书(没搬输出 0)。

$n\le 2\times 10^5$

$Solution$

开一个桶记录每一本书的位置,记录当前搬到那个位置了,每搬一次就更新一下,减一下即可。

C. Vasya and Robot

$Problem$

有一个机器人,初始在 $(0,0)$ 点,给你一个长度为 $n$ 的操作序列,每次让机器人向上、下、左、右中的一个方向走一步,你需要修改连续的一段操作序列(这一段中的操作不必全部都修改),使它最终走到 $(x,y)$ 点,问修改的操作序列的最短长度。(不是很严谨,序列长度的详细定义见原题面)

$n\le 2\times 10^5$

$Solution$

如果修改一个长度为 $len$ 的序列可以使它走到终点,那么一定存在一种长度为 $len+1$ 的方案也能走到终点(大不了就加一个空修改),于是我们发现这是可以二分的。二分最终修改的长度 $len$,对于一个长度,我们需要 $O(n)$ 判断是否可行,怎么判断呢?对于每一段长度为 $len$ 的修改,判断不考虑这段修改后机器人会走到哪个位置,再从这个位置开始,判断随便走 $len$ 步能否走到终点(反正允许修改这一段,那想怎么改就怎么改)。

实现上,我们维护一个走的位置的前缀和和后缀和,就可以 $O(1)$ 判断去除这段修改后机器人会走到那个位置,然后再考虑一些细节问题即可。

D. Berland Fair

$Problem$

有一个人前来买东西。Polycarp 带了 $T$ 元钱,去逛商铺。有 $n$ 家商铺顺时针排成一圈,编号 $1-n$,第 $i$ 个商铺卖一种价格为 $a_i$ 的商品(数量有无限个)。Polycarp 从一号商铺开始,只要钱足够,就买一件商品,否则跳过这家店,直到他一个商品也买不了为止,问他一共会买多少件商品。

$n\le 2\times 10^5,T\le 10^{18},a_i\le 10^9$

$Solution$

先算出来买一圈要花多少钱,让他买尽可能多的圈。为什么他买不了下一圈了呢?一定是到某一个商铺是他买不起了。现在买不起,以后也不可能买的起,于是直接把这个商铺删掉,不考虑。于是我们暴力跑一圈,看看是哪些商铺买不起,把它们都删掉,删完后再让他转圈,知道所有的商品全都被删完为止。由于每一次至少删掉一个商品,最多删 $n$ 次,每次 $O(n)$,总时间复杂度为 $O(n^2)$。(别问我为什么能过 $2\times 10^5$,我也不知道)(经过同学推导,复杂度为 $O(n\log(n))$)

EDU-CFR-115(Div.2)解题报告

avatar cxm1024 2025-12-01 12:52:18

本文章由 WyOJ Shojo 从洛谷专栏拉取,原发布时间为 2021-10-14 15:48:10

更好的阅读体验

赛时AC 3道,补题做出来一道

A. Computer Game

$Problem$

有一个 $2\times n$ 的01矩阵,1为障碍,你要从 $(1,1)$ 走到 $(2,n)$,每一步只能向右、上、下、右上、右下走,问能不能走到。

$t\le 100,n\le 100$

$Solution$

如果有一列的两个数都是1,则一定会被堵住,否则一定能到,因为每一列至少有1个0,而我们可以斜着走,所以一定可以从一列走到下一列。

B. Groups

$Problem$

有 $n$ 个学生($n$ 是偶数),每个学生在星期一到星期五会有若干天空闲,问能否将学生平均分成两组,使得每一组能够挑选一天组织社团活动(两组选的日子不能相同)。

$t\le 10^4,\sum n\le 10^5$

$Solution$

由于一周只有五天,考虑枚举选的是哪两天,然后判断可不可行。判断就需要一点脑洞了,我的方法是如果两天的空闲学生人数都 $\ge n/2$,且交集能够覆盖所有学生(即每个学生都在这两天中至少有一天空闲),就一定可行。

C. Delete Two Elements

$Problem$

给你一个长度为 $n$ 的序列,问有多少种选出两个数的方案使得删除它们后平均值不变。

$t\le 10^4,\sum n\le 2\times 10^5,a_i\le 10^9$

$Solution$

要想删除后平均值不变,取出的两个数的平均值必须等于全部的平均值,即两个数的和必须等于全部平均值的两倍,如果数列的平均值 $\times 2$ 不是整数则一定不可行(选出的两个数的和一定是整数),我们如果已经选出了一个数,就可以知道另一个数应该是多少,于是我们可以想到开一个桶,但 $10^9$ 开不了桶怎么办?用 map 即可。

D. Training Session

$Problem$

教练有 $n$ 道题,每道题有一个算法主题 $x$ 和难度 $y$,你需要选出恰好 $3$ 道题使得 $x$ 互不相同或 $y$ 互不相同。问有多少种选法。保证没有两个完全相同的题。

$t\le 50000,\sum n\le 2\times 10^5,x,y\le n$

$Solution$

考虑用总方案数减去不合法方案数,不合法的方案就是有两个题的 $x$ 相同,有两个题的 $y$ 相同,表现在坐标系上,每一个点的贡献就是横坐标相同的点数$\times$纵坐标相同的点数,可以开两个桶维护。

cxm1024 Avatar
wfyz 太有实力了
标签
暂无
活跃度 近 53 周
查看全年